ESP32-S3 запускает LLM на 28,9 млн параметров — с трюком из Google Gemma
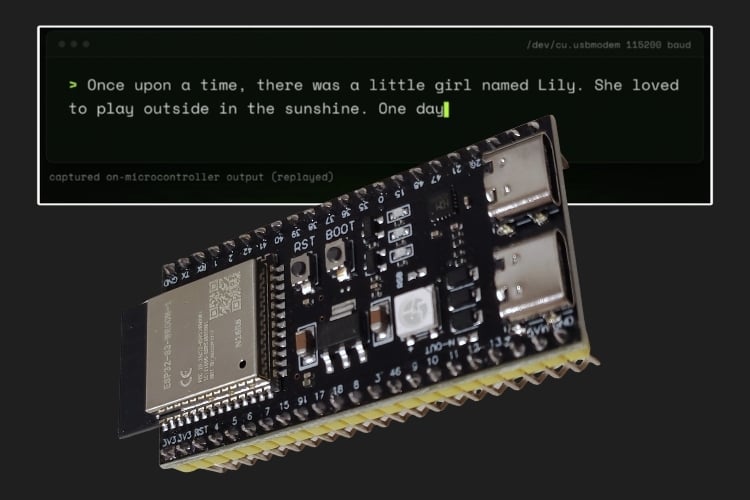
Перевод статьи ESP32-S3 Runs a 28.9-Million-Parameter LLM, Borrowing a Memory Trick From Google’s Gemma — Circuit Digest.
Разработчик slvDev опубликовал открытый проект, который запускает языковую модель на 28,9 млн параметров прямо на ESP32-S3 — микроконтроллере стоимостью около $8. Модель работает целиком на самом чипе, без отправки данных на сервер, генерируя текст со скоростью примерно 9 токенов в секунду и выводя его на небольшой подключённый дисплей. Достижение выделяется тем, как мало оперативной памяти есть у ESP32-S3 — всего 512 КБ SRAM, — а прежняя самая крупная языковая модель, запущенная на сопоставимом железе, доходила лишь до примерно 260 000 параметров. То есть эта — примерно в 100 раз больше.
Обходной приём заимствован у моделей Google Gemma и называется Per-Layer Embeddings. Большая часть параметров языковой модели лежит в таблице эмбеддингов, из которой модель только читает, а не вычисляет по ней. slvDev держит эту таблицу на 25 млн параметров в более медленной флеш-памяти чипа, подтягивая всего около шести строк — примерно 450 байт — на токен, тогда как меньшая, тяжёлая по вычислениям часть модели остаётся в быстрой SRAM. В итоге большая модель почти не касается ограниченной ОЗУ чипа, ведь целиком она никогда не загружается. По характеристикам: квантованная модель весит 14,9 МБ при 4-битной точности и работает на железе с 8 МБ PSRAM и 16 МБ флеш-памяти в дополнение к 512 КБ SRAM.
Модель не универсальная. Её обучили на датасете TinyStories, и она выдаёт короткие, в основном связные истории, но не умеет отвечать на вопросы, следовать инструкциям, писать код или вспоминать факты. Смысл проекта, по словам автора, — продемонстрировать архитектуру работы с памятью, а не возможности самой модели. Прошивка, инструкции по подключению, код обучения и полный разбор бенчмарков доступны в репозитории проекта на GitHub — вместе с историей коммитов, документирующей найденную и исправленную по ходу дела ошибку в подсчёте параметров.